
– Vi ser at folk regelmessig registrerer DNA-sekvenser som ikke finnes naturlig. Hvis du da henter ut disse sekvensene, blir du lurt, slår professor i bioinformatikk, Eivind Valen fast.
Han er fortvilet over at DNA-databasene inneholder feil. Ifølge ham skyldes dette at mange prøver å få virkeligheten til å passe inn i definisjonene, og ikke motsatt. Det mangler en definisjon som er både presis og bred nok til å fange alt som foregår i naturen.
Mangler et begrep som forklarer det som faktisk skjer
Definisjonen handler om områder i DNAet som blir oversatt til proteiner. Hvis proteinet har en kjent funksjon, kaller vi området for et gen. Det er mange flere slike områder hvor det ikke er en kjent funksjon.
– Begrepet som ofte brukes om de oversatte områdene er ORF. Det er både for bredt og for smalt samtidig. Det dekker ikke alt det som blir til proteiner i naturen. Samtidig inkluderer det mange sekvenser som ikke blir til proteiner, forklarer han.
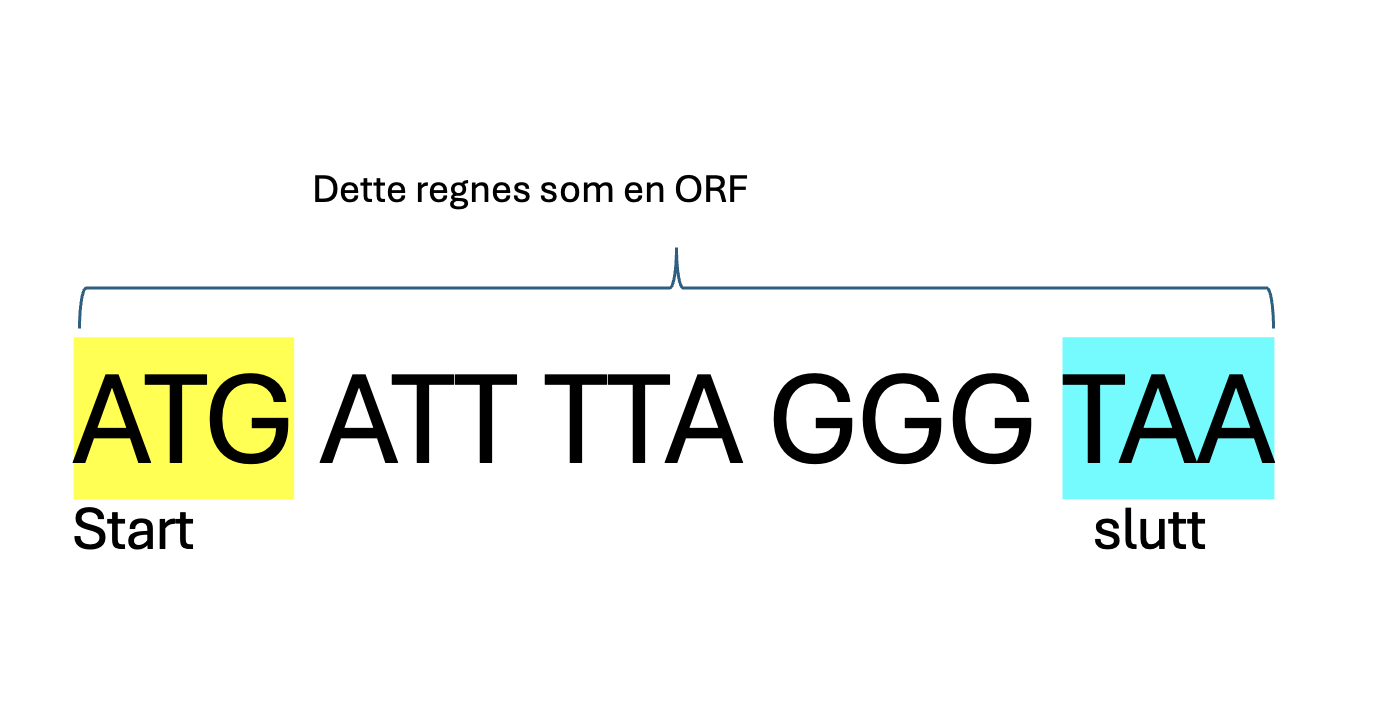
Det skyldes definisjonen av ORF. Ifølge definisjonen er det en gitt rekkefølge som markerer starten. Deretter leses genet av uten avbrudd eller hopp, før en ny rekkefølge som markerer slutten. Dette er oppskriften på noen proteiner, men langt ifra alle.
Derfor har Valen foreslått et nytt begrep: translon, for alle områder som blir oversatt til proteiner. Med på laget har han 200 andre forskere.
Definisjoner
Hva er en ORF:
ORF er en forkortelse for «Open Reading Frame» eller åpen leseramme. Det er et område i DNAet med en klar start og en klar slutt. Alt imellom dette området kan være oppskriften på et protein, eller et gen, men forskning har vist at det ofte ikke er så enkelt.
Hva er en translon:
En translon er en forkortelse for det engelske «translated region». Det er et område som blir oversatt til et protein. Dette begrepet rommer mer enn ORF, fordi det også dekker områder uten klare start- og slutt-signaler eller med rammeskifter. Derfor mener Valen at dette er mer i tråd med det som faktisk finnes i naturen.
Eksempel på feil forskerne legger inn i databasene
– Et eksempel på problemene som oppstår, er når proteiner lages. Da leses basene vanligvis tre og tre av gangen. Av og til ser vi at en base hoppes over og ikke leses av, forklarer han. Dette gir et såkalt «rammeskifte» og det har store konsekvenser for hva proteinet blir.
ORF-begrepet tar ikke høyde for at det finnes rammeskift. Siden mange databaser forventer en ORF, tyr mange forskere til å endre sekvensene slik at de skal bli en ORF, for eksempel ved å fjerne en base som hoppes over før de legger dem i databasene. Dette blir feil og gir opphav til sekvenser som ikke finnes i naturen.
– Vi har dessverre mange eksempler på dette fordi ORF-konseptet blir tvunget inn på områder hvor det ikke passer inn, sier Valen.

Naturen er full av «ville» tilstander
Valen forteller videre at selv om de fleste proteiner i mennesker er kodet av ORFer er det mange organismer som slett ikke følger et så regelbundet oppsett. Naturen er tross alt «vill».
– Bakterier og virus har mange ulike måter å lese av på. De har rammeskifter og andre ville tilstander. De kan hoppe over mange baser og har ikke nødvendigvis sammenhengende områder som blir oversatt til gener, forklarer han. Det passer ikke inn i ORF-begrepet, slår han fast.
DNA:
DNA er forkortelsen for deoksyribonukleinsyre. Det er et molekyl som kan lagre informasjon om hvordan en biologisk organisme skal bygges opp.
Baser:
DNAet lagrer informasjon ved hjelp av fire baser: A, T, C og G. Rekkefølgen på basene er måten informasjonen lagres, og leses av på.
Rammeskifte:
Når et protein lages blir DNAet først omgjort til RNA og sekvensene leses så av tre og tre baser av gangen. Hver kombinasjon av 3 baser blir «oversatt» til en spesifikk aminosyre. Rekkefølgen på aminosyrene blir til et protein. Dersom det blir lagt inn, eller trukket fra, en eller to baser, blir grupperingen av 3-og-3 baser forskjøvet og en annen gruppering blir dannet. Dermed blir aminosyrene og proteinet helt annerledes.
ORFs kan finnes mange steder i DNAet uten å ha noe med gener å gjøre
Han legger til at mange tenker på ORF som potensielle proteiner, men bare fordi man finner en kode for «start» og en kode for «slutt» betyr det slettes ikke at det blir til et protein.
– Vi har tre milliarder basepar. Det skal ikke så mye til å finne et område som tilfeldigvis kan leses som start med et tilfeldig område som slutt. Det sier likevel ikke noe om at dette området er oversatt til et protein. ORF er definert utelukkende ifra sekvensen, ikke fra biologiske prinsipper, forklarer Valen.
Han forteller videre at det finnes andre rare eksempler på at ORF-begrepet ikke egentlig er dekkende for det som skjer:
– Det hender at stoppsignalet slettes ikke er der protein oversettelsen stopper, men at den i stedet stopper et annet sted.
– Når vi kaller noe slikt en ORF, er det beviselig feil, sukker han.
Det er «hull» i kunnskapen om gener
Valen forteller også at med den økende kunnskapen om DNAet og genetikk har forskere funnet en tidligere helt ukjent verden av små områder som potensielt kan bli til små mikroproteiner. Foreløpig er funksjonen til disse uklar.
– Det kan også være områder av et vanlig gen som ikke er med i det vanlige protein-sluttproduktet, men som likevel har potensialet til å produsere mikroproteiner, sier Valen. Det har vært økende interesse for disse i det siste, blant annet innen kreftforskning. Noen kaller disse for dark proteome og andre fantasifulle begreper. Vi lurer jo på hva alt dette er, og hva de gjør. Vi har ikke hatt noe godt ord for hva vi skal kalle disse områdene som ikke er en del av kjente proteiner. Derfor har vi introdusert begrepet translon nå.
Han håper at det nye begrepet gjør at forskere slipper å tvinge sekvenser inn i ORF-begrepet slik at DNA-databasene stemmer overens med det som faktisk finnes. Siden det fremdeles er mye vi ikke vet om DNAet, er det viktig å heller bruke en mer åpen definisjon for å unngå feil.
Les artikkelen her:
Świrski, M.I., Tierney, J.A.S. mfl; Translon: a single term for translated regions. Nature Methods, september 2025,


